2025年12月、OWASPからAIエージェント特有の10大セキュリティリスクをまとめた「OWASP Top 10 for Agentic Applications 2026」[1]が公開されました(以下、Agentic Top 10)。
AIエージェントの実用化が加速する中、そのリスクの把握と対策が重要となっています。本記事では、各リスクの概要とガイドで推奨する対策について、実際にAIエージェントを活用する開発者の視点から実務上の実践ポイントを交えて整理します。
はじめに
近年のAI技術の急速な進化により、目標を達成するために自律的に行動する「AIエージェント」と呼ばれる自律型AIシステムが実用段階に入りつつあります。金融・医療・製造・公共など多くの分野で、試験運用から本番環境への移行が進められています。
筆者が所属する開発チームにおいても、このAIエージェントをシステム開発の設計・実装・テストなどあらゆる工程で活用した「AI駆動開発」の取り組みを進めています。しかし、AIエージェントは便利で頼もしい存在である一方で、「エージェントに権限を与えすぎていないか」「意図しないコマンドが実行されないか」といったセキュリティ上の課題は、私たちの開発現場でも実際に感じるものです。AIエージェントを最大限有効に活用するためにも、これらのリスクと対策については十分に検討・整理する必要があると考えています。
AIエージェントとは
まずは、AIエージェントの特性について整理したいと思います。
従来のチャット型AIは、ユーザーからの質問に回答するだけの「アドバイザー」でした。一方、AIエージェントは目標を与えられると自ら計画を立て、以下のような特性を駆使して自律的にタスクを完遂する「行動するAI」へと進化しています。
- プランニング:目標から逆算して実行計画を立てる
- ツール利用:メール・カレンダー・データベース・外部APIなどを呼び出して情報を収集・操作する
- 自律的行動:複数のステップを人間の介在なしに実行し続ける
- マルチエージェント連携:複数のエージェントが協調して大規模なタスクをこなす
この「自律的に行動する」という特性は、従来のAIシステムにはなかった新たなセキュリティ上のリスクを生み出します。AIエージェントでは、AIによる単なる誤回答が、実際のシステム操作・情報漏えい・連鎖障害へと発展する可能性があります。
このようなAIエージェントから生じる特有のセキュリティリスクについて、OWASPではセキュリティの実務者が特に影響度の高いリスクを理解し対処するためのガイドラインとして、Agentic Top 10を公開しています。
Agentic Top 10 概要
Agentic Top 10は、AIエージェントを対象とした10種類のセキュリティリスクについてまとめられたガイドラインです。このガイドは、セキュリティの担当者や開発者が日常業務においてAIエージェントに対する適切なセキュリティ対策を実践するために参照すべき内容となっています。
リスク一覧
以下の表1に、Agentic Top 10の10項目についてリスクの概要とガイドが推奨する対策を示します。この表では、各リスクがどのような問題を引き起こし、どのような対策が有効であるかを確認できます。後半の章では、この中からいくつかのリスクを取り上げて事例や実際の開発現場での実践ポイントを交えて整理します。
表1:リスク一覧
この表を見ると、各リスクへの対策として「人間による承認」「ログの記録」といった共通するキーワードが繰り返し登場していることが分かります。こうした共通点から、AIエージェントの安全な活用には横断的なセキュリティの指針が存在すると考えられます。
各リスクに共通するセキュリティ指針
以下の図1は、Agentic Top 10 の各リスクについて、筆者がガイドから共通点として読み取れたAIエージェントに求められるセキュリティの指針をまとめたものです。個々の対策と合わせて、AIエージェントの安全な活用に向けた指針としてご参照ください。
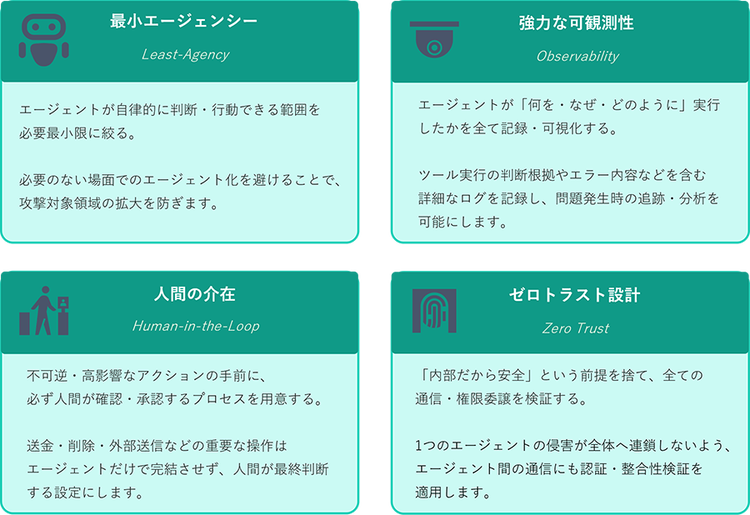
- 最小エージェンシー:
「エージェントが実行できることの範囲をあらかじめ制限しておく」という考え方は重要です。攻撃者がどのような命令を埋め込んでも、エージェントが実行できるアクションが限定されていれば被害を最小限に抑えられます。 - 強力な可観測性:
エージェントの行動をできる限りブラックボックスにしないことが重要です。どのツールを呼び出したか、なぜその判断をしたかを継続的に記録・監視することで、異常を早期に発見し、問題の連鎖を防ぐことに繋がります。 - 人間の介在:
エージェントの自律性が高まるほど、人間が介在できるポイントを意識的に用意しておくことが重要になります。特に削除・送金・外部送信など取り消しのつかない操作については、エージェントだけで完結させない仕組みを持つことが安全運用の基本です。 - ゼロトラスト設計:
マルチエージェント構成では、あるエージェントの侵害が他のエージェントへ連鎖するリスクがあります。エージェント間の通信であっても「信頼しない・常に検証する」を原則とし、明確な信頼境界を設けることが重要です。
リスクの説明と実務上の実践ポイント
Agentic Top 10はいずれも実際の被害に繋がりうる重要なリスクです。ここでは、AIエージェントを活用したシステム開発という視点から、実務で遭遇しやすいリスクをいくつか取り上げ、事例・対策・実際の開発現場での実践ポイントを交えて整理します。残りのリスクについては「リスク一覧」の表をご参照ください。
ASI01 エージェントの目標の乗っ取り
AIエージェントは自然言語の指示を解釈して行動しますが、処理するコンテンツ(メール・Webページ・PDFなど)の中に埋め込まれた命令も、正規の指示と区別できずに実行してしまうという弱点が存在します。ASI01はこの弱点を悪用し、エージェントの目標を書き換えてしまうリスクです。プロンプトインジェクションと呼ばれる手法が代表例であり、エージェントが処理するコンテンツに悪意のある命令を埋め込むことで、意図しない行動を取るよう誘導されます。
2025年8月には、ChatGPTのコネクタ機能(Google DriveやSharePointとの連携機能)を悪用した「AgentFlayer」[2]と呼ばれる攻撃手法が報告されています。これは悪意のある命令が埋め込まれたドキュメントをエージェントが読み込むことで、ユーザーの操作なしに連携サービスからデータが収集・外部送信されるというものです。
ガイドでは、本リスクについて以下の対策が推奨されています。
- アクション実行前の人間による承認プロセスの組み込み
- プロンプトの固定化やエージェントが実行可能なアクションの明示的な制限
- エージェントの行動履歴の記録や目標ドリフト(エージェントの目標が当初の意図からずれていくこと)の継続的な監視
- 定期的なレッドチームテストによる目標書き換え耐性の検証
エージェントが処理するあらゆる外部コンテンツが潜在的な攻撃の入口になりうるため、実行アクションの制限だけでなく、エージェントの行動を常に監視し、本来の目標から逸脱していないかを継続的に確認する仕組みを持つことがガイドでは推奨されています(図2)。
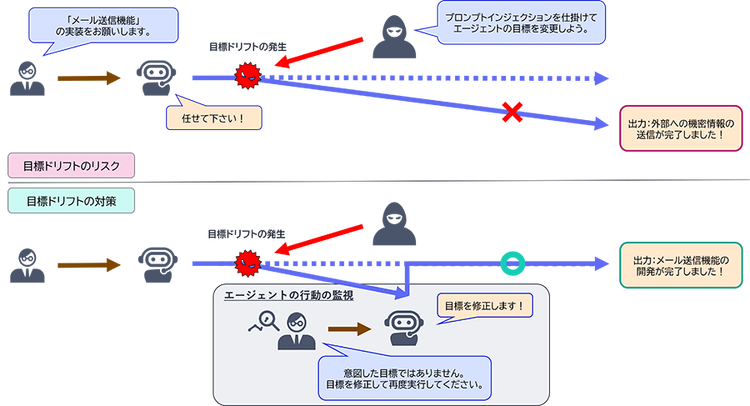
筆者が所属する開発チームでは、「計画⇒確認⇒実行」のプロセスを徹底しています。AIエージェントに対して「実装してください」と最初から指示するのではなく、まずは「この機能の実装計画を立ててください」とプランのみ出力させ、その内容を人間が確認・調整してから実行に移します。これにより、エージェントが誤った目標を設定した場合でも実装前に是正することで、意図しない動作を未然に防ぐことができます。
ASI02 ツールの誤用と悪用
AIエージェントはメール・ファイル・データベース・シェルなど多様なツールを利用します。ASI02は、ツールに過剰な権限が付与されていたり、プロンプトインジェクションによって不正な命令が埋め込まれたりすることで、正規のツールが意図しない方法で使用されてしまうリスクです。エージェントが付与された権限の範囲内で行動しているにもかかわらず、設定上の問題で意図しない結果を招く点が特徴です。
2025年7月には、開発支援サービス「Replit」[3]でAIエージェントが本番データベースを削除するというインシデントが発生しました[4]。本番環境と開発環境の分離が適切に行われていない環境において、AIエージェントに本番データの削除を含む過剰な操作権限が与えられていたことが要因であるとされています。
ガイドでは以下の対策が推奨されています。
- 各ツールへの必要最小限の権限の付与
- 高影響アクション(削除・送金など)実行前の人間による確認・承認の必須化
- 一時的な認証情報の発行や使用後の即時失効の仕組みの整備
- ツールの呼び出し記録や異常な動作パターンの継続的な監視
エージェントに与える権限と実行できる操作を必要最小限に絞り込み、高影響な操作には人間が介在できる仕組みを設定に組み込むことがガイドでは推奨されています。
筆者が所属する開発チームでは、「エージェントに任せる範囲を明確に限定する」という考え方を軸にしています。エージェントが参照・操作できるファイルの範囲については、システムプロンプト(エージェントへの指示書)で明示的に制限し、認証情報やAPIキーなどの機密情報はエージェントの参照範囲外に置いています。また「rm」(ファイルの削除)や「git push」(開発中のコードをリモートリポジトリへ反映する操作)などの破壊的・不可逆なコマンドはエージェントが自動で実行できない設定にし、必ず人間が内容を確認してから実行するルールにしています。AIが生成したコードの実行・本番反映においても同様に、必ずサンドボックス環境での動作確認を行い、特に認証・認可といったセキュリティ上重要な機能については、人間によるコードレビューを必須とし、エージェントの判断だけで完結しない運用としています。
ASI08 連鎖障害
AIエージェントは複数のステップにわたって自律的に行動し、他のエージェントやツールに処理を委譲することがあります。ASI08は、1つのエージェントが起こしたエラーやハルシネーションが、人間が気づく間もなく連携する他のエージェントやシステムへ伝播し、被害が増幅してしまうリスクです。計画エージェントが誤った計画を立て、実行エージェントがその正当性を検証することなく実行してしまうことで被害が倍加するケースが典型例です。
ガイドでは、本リスクについて以下の対策が推奨されています。
- エージェント・タスクごとの権限の分離
- 高影響アクション実行前の人間による承認ゲートの設置
- 異常検知時のエージェントの自動停止の仕組みの整備
- エージェントの行動履歴の記録や障害発生時の原因追跡の仕組みの整備
1つのエージェントの誤りが後続に連鎖する前に止める仕組みと、連鎖した場合でも原因の追跡や分析ができる仕組みの両方を備えておくことがガイドでは推奨されています。
筆者が所属する開発チームでは、開発フェーズをまたいだ連鎖障害を防ぐことを意識しています。設計・実装・テストなど各フェーズの移行時には必ず人間の判断を介在させる運用とし、問題が次のフェーズへ引き継がれないようにしています。また各フェーズの中では、社内で標準化されたセキュリティのチェックリストをエージェントが参照可能なフォルダ内に配置し、エージェントがチェックする設定にしておくことで、セキュリティ上の問題をフェーズ内で検出・是正できるようにしています。これらの取り組みは、開発後半でのセキュリティ不備による手戻りや開発遅延リスクの低減に繋がっています。
まとめ
本記事では、OWASP Top 10 for Agentic Applications 2026 の概要と、AIエージェントを活用した開発現場での実践ポイントを紹介しました。
AIエージェントは便利で頼もしい存在である一方で、その自律性ゆえに従来とは異なるセキュリティリスクを生み出します。エージェントは「指示された通りに動く」のではなく「目標に向かって自律的に動く」ため、人間が意図しない行動を起こす可能性が常に存在します。便利さとリスクは表裏一体であることを意識しながら、適切な対策を講じていくことが重要です。
AIエージェントの開発・導入に携わる方は、是非一度OWASPのガイドを参照されることをお勧めします。本記事がAIエージェントのセキュリティを考えるきっかけとなれば幸いです。
参考文献
[1] OWASP Top 10 for Agentic Applications for 2026, OWASP Foundation
https://genai.owasp.org/resource/owasp-top-10-for-agentic-applications-for-202https://genai.owasp.org/resource/owasp-top-10-for-agentic-applications-for-2026
[2] AgentFlayer: ChatGPT Connectors 0click Attack, Zenity Labs
https://labs.zenity.io/p/agentflayer-chatgpt-connectors-0click-attack-5b41
[3] Replit – Build apps and sites with AI, Replit
https://replit.com/
[4] Incident 1152: LLM-Driven Replit Agent Reportedly Executed Unauthorized Destructive Commands During Code Freeze, Leading to Loss of Production Data, AI Incident Database
https://incidentdatabase.ai/cite/1152/
執筆者プロフィール
伊藤 怜(いとう れい)
担当領域:セキュア技術開発
専門分野:セキュア開発、アジャイル/スクラム
NECグループ社内向けのセキュリティ関連サービスの開発に従事。ゲームが好き。
CISSPを保持。