本記事では、Webアプリケーション診断でよく使われるBurp Suiteの拡張機能のうち、AIを活用した「Custom AI Agent」Iを取り上げ、実際に触ってみた様子をご紹介します。本拡張機能は非常に多くの機能を持ちますが、本記事ではその一部に絞ってご紹介します。
本拡張機能は、過去には「Burp AI Agent」という名称で公開されていましたが、Burp Suite Professionalに標準搭載されている「Burp AI」との混同を避けるため、現在は「Custom AI Agent」に名称が変更されています。なお、GitHubリポジトリ名や設定ディレクトリ名は、継続性維持のため、旧名称の burp-ai-agent が使用されています。
注意事項
本ブログは、筆者による独自の調査に基づいて執筆していますが、記載内容がすべて正確・最新であることを保証するものではありません。また、本ブログの内容を使用したことによって発生する不利益等について、筆者および関係者はいかなる責任も負いません。
利用環境
Burp Suite Professional(v2026.6)
Custom AI Agent(v0.9.0)
OllamaⅡ(0.32.1)
gemma4:e4bⅢ
VulnerableApp(2.1.0)
Custom AI Agentとは
Custom AI Agentは、Burp SuiteにAI機能を統合するための拡張機能で、MITライセンスで公開されているOSSですIV。クラウドおよびローカルの複数のLLMバックエンドに対応しており、MCP(Model Context Protocol)サーバーを内蔵しているほか、パッシブ/アクティブのAIスキャナーによる自動的な脆弱性検出機能を備えています。SQLインジェクションやXSSといった定番の脆弱性から、キャッシュポイズニング、JWT攻撃、API固有のセキュリティ問題まで、幅広い脆弱性クラスをカバーしています。
本拡張機能の特徴は、Burp Suiteのコンテキストメニュー(右クリックメニュー)から、リクエストの解析、JavaScriptの説明、PoCの草案作成、発見事項(Issue)の説明文生成といった作業を、Burpの画面から離れることなくAIに任せられる点です。ローカルLLMを使えば外部にトラフィックを送信することなく作業でき、クラウドのLLMプロバイダーを使う場合にも、後述するマスキング制御をかけることができます。
Custom AI Agent が持つ機能のリスト
本記事ですべてを扱うわけではありませんが、主な機能Vを整理すると以下のとおりです。
- 複数のLLMバックエンド対応:Burp AI(Burp Suite組み込み)、Ollama、LM Studio、NVIDIA NIM、Perplexity、OpenAI互換API、各種CLIエージェント(Gemini/Claude/Codex等)、Anthropic APIなど。Burp AIバックエンドのみBurp Suite Professionalの「Use AI for extensions」トグルに依存し、それ以外は独立して動作する。
- MCPサーバー内蔵:Burp履歴・Repeater・Scanner・スコープ・Issueワークフローを操作するツール群を公開。外部のAIエージェント(Claude Desktop等)からBurpを操作させることもできる。
- AIスキャナー(パッシブ/アクティブ):トラフィックを解析し、62の脆弱性クラスをカバーして自動的にBurp Issueを作成する。
- プライバシーモード:STRICT / BALANCED / OFF の3段階で、LLM処理の前に機密データをマスクする。
- Agent Profiles:pentester / bughunter / auditor といった役割別のシステムプロンプトを注入し、診断の種類に応じてLLMの振る舞いを変えられる。
- Custom Prompt Library:HTTPリクエストやスキャナーIssueといったコンテキストごとに、自由記述のプロンプトを保存して右クリックから呼び出せる。
- 監査ログ / AI Logger:全LLM呼び出しをトレースID付きで記録し、コンプライアンスや再現性に対応する。
なお、MCP連携について今回はスコープ外とし、まずは各機能の確認を実施しました。
検証環境:やられWebアプリ「VulnerableApp」
検証には、やられWebアプリケーションであるVulnerableAppVIを使用します。VulnerableAppは、あらかじめ複数の脆弱性が盛り込まれたJavaベースの学習用Webアプリケーションで、以前の記事VIIでもご紹介したものです。
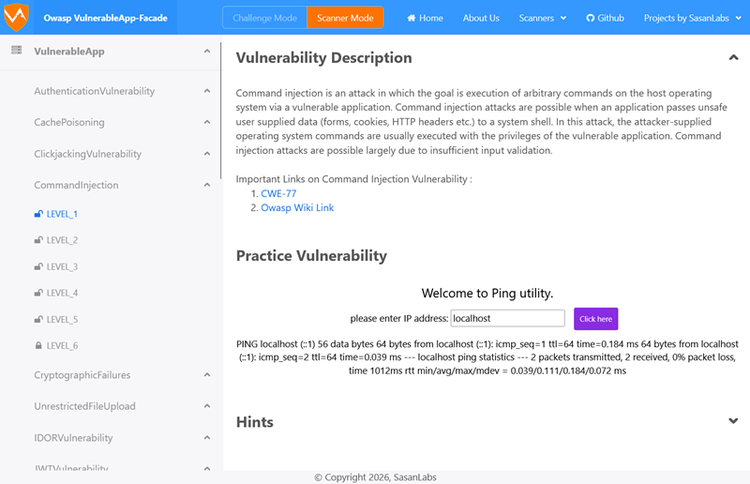
前回記事の執筆時(2022年5月)からVulnerableAppは複数回更新され、最新のv2.1.0では脆弱性カテゴリが増えています。主な追加項目は以下のとおりです。
- IDOR(Insecure Direct Object Reference)
- Clickjacking
- LDAP Injection
- Authentication Vulnerability
- Cryptography Failures
- Cache Poisoning
また、v2.0.0では、プロンプトインジェクションやデータ漏洩などを体験できるLLMセキュリティ演習モジュール「LLMForge」が追加されています。本記事では扱いませんが、AIセキュリティの学習・検証にも利用できます。なお、前回記事で扱ったCommand InjectionやSSRFなどの課題も、現行版で引き続き利用できます。
Custom AI Agent の設定手順
Custom AI Agentの設定手順を説明します。
まず、公式のGitHubのリリースページからjarをダウンロードします。続いて、Burp SuiteのExtensionsタブ → Installedタブから「Add」をクリックします。Extension file (.jar) の「Select file」から、先ほどダウンロードしたjarファイルを選択します。読み込みに成功すると、Burp Suiteのタブの一番左に「Custom AI Agent」タブが追加されます。
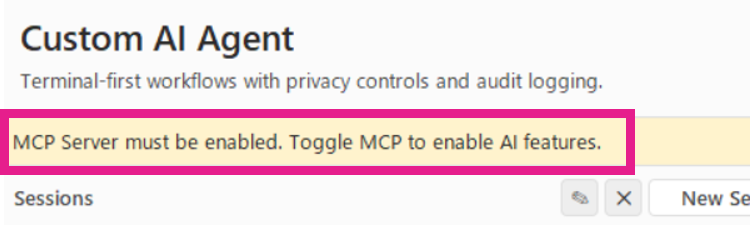
拡張機能タブを開いたら、MCPのトグルをOnに変更します。PassiveやActiveのトグルも、必要に応じてOnに変更します。Backendでは、利用するLLMプロバイダーを選択します。

本記事では、外部からMCPを使ってBurp SuiteやCustom AI Agentを操作することはしませんが、MCPをOffにした状態ではAI機能を利用できなかったためOnにしています。
LLMプロバイダーの設定
まずは、LLMを提供する環境を準備します。Custom AI Agentで用意されている対応バックエンドは次のとおりですVIII。
- Burp AI(Burp Suite Professional組み込み)
- Ollama
- LM Studio
- NVIDIA NIM
- Perplexity
- OpenAI互換API
- Anthropic API
- Gemini CLI / Claude CLI / Codex CLI / OpenCode CLI / Copilot CLI(各種CLIエージェント)
本記事では、ローカルLLMであるOllamaを使用し、モデルはgemma4:e4bを使用します。ご自身の環境に合わせて、任意のプロバイダーと任意のモデルを試してみてください。
Custom AI Agentタブの左上に「Backend」という選択式の項目がありますので、「ollama」を選択します。続いて、Ollamaへの接続情報や利用するモデルの設定を行います。適宜、環境に合わせて設定してください。設定できる主な項目は以下のとおりです。
- Ollama base URL:デフォルトは http://127.0.0.1:11434
- Ollama model:pull済みのモデル名(例:gemma4:e4b)
- Ollama timeout (seconds):応答待ち時間(デフォルト120秒)
- Ollama serve command / Auto-start Ollama server:Ollamaサーバーが起動していない場合に自動起動させるためのコマンドとトグル
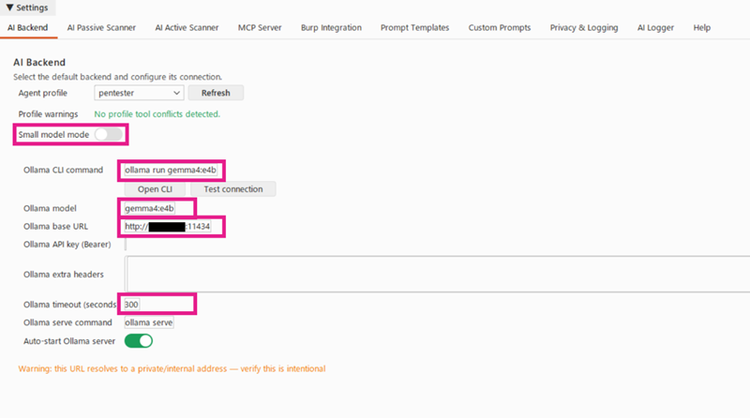
「Test connection」ボタンで接続の確認ができます。また、左上の「AI: OK」や「AI: Offline」といった表示でも接続状況を確認できます。
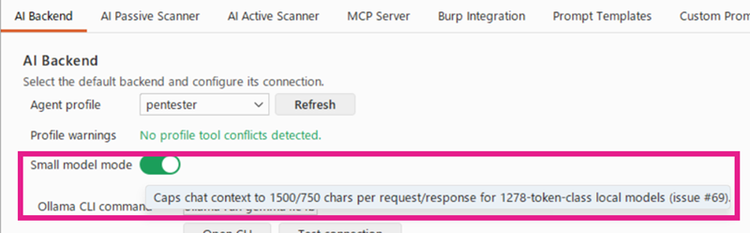
なお、「Small model mode」をOnにすると、チャットに含めるリクエスト/レスポンスボディがそれぞれ1500/750文字に制限されます。小型のローカルモデルへの入力を抑え、コンテキスト超過による処理の破綻を防ぐための機能です。
Prompt Templatesの設定
Prompt Templatesでは、各機能でLLMにリクエストを送る際のプロンプトを編集することができます。私は、まずはデフォルトのまま利用してみました。
Privacy & Loggingの設定
Privacy & Loggingからは、LLMに送信するトラフィックのマスキングレベルの設定と、監査ログの設定を行うことができます。マスキングとは、Cookie・認証ヘッダー・トークン・機密なURLパラメータなどが、BurpからLLMプロバイダーに送信される前に除去するかどうかを制御するものですIX。
Privacy modeは、本記事ではデフォルトのBALANCEDを選択しています。Privacy modeは、機密パラメータをマスクする度合いを決めるパラメータです。なお、本記事ではローカルLLMを利用しているため、挙動について詳細な検証は行っていません。クラウド系のLLMを使う場合には、利用前に設定内容を確認しておくと良いでしょう。
Audit loggingは、必要に応じてOnにします。Onにした場合は、以下の場所にファイルが生成され、LLMへの問い合わせログが記録されますX。
%USERPROFILE%\.burp-ai-agent\audit.jsonl
このログは、イベントごとにペイロードのSHA-256ハッシュが付与されたJSONL形式で記録されます。記録内容はイベントの種類によって異なり、LLMの応答全文が残らない場合があります。この点については「気になった点」であらためて触れます。
AI Loggerの設定
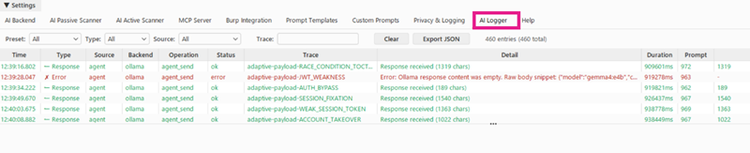
AI Loggerタブでは、LLMへのリクエスト状況がリアルタイムに表示されますXI。フィルタによる絞り込みができ、どの機能から何件のLLM呼び出しが発生しているかを確認できます。「どの機能が実際にLLMを呼び出しているのか(あるいは呼び出していないのか)」を確認したいときに、最も役立つタブだと感じました。
利用例①:リクエストの調査・確認
ここからは、TargetタブやProxyタブなどリクエストを表示している画面で右クリックして使える機能を紹介します。リクエスト上で右クリック→Extensions→Custom AI Agentから選択可能な機能は以下のとおりです。
- AI Passive Scan★後述
- AI Active Scan★後述
- AI Scan on Selected Insertion Point ★後述
- Targeted Tests(サブメニュー)★後述
- Find Vulnerabilities★後述
- Analyze this request★後述
- Explain JS
- Extract JS Endpoints
- Test 403 Bypass
- Access control
- Login sequence
- Custom prompts
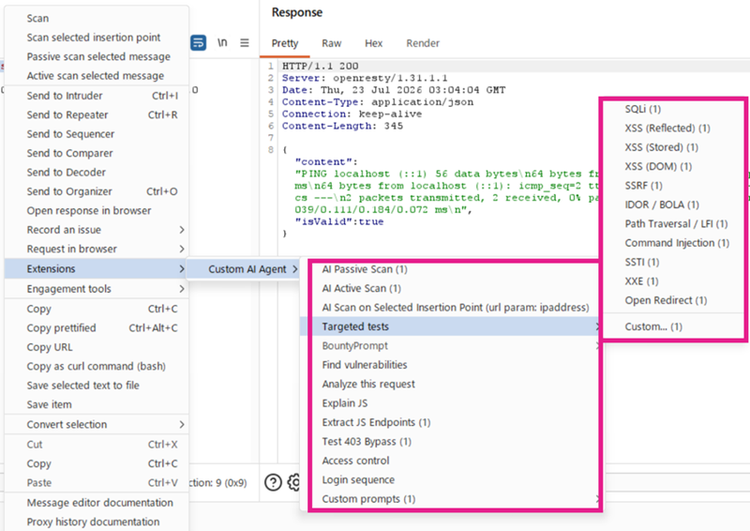
これらの機能で発見された事項(Issue)は、Burp SuiteのIssues項目に、[AI]というプレフィックスが付いた件名として報告されます。具体的なイメージについては、後述する利用例②を参照してください。
AI Passive Scan
Custom AI Agent上部のPassiveトグル、もしくはAI Passive ScannerタブのEnable ScannerトグルがOnになっている場合、Burp Suiteを通過した通信に対して、自動的にAI Passive Scanが実行されます。これは、Burp本体のスキャンエンジンにフックする PassiveScanCheck という仕組みで動作しています。この仕組みはBurp Suite Professional専用のため、Community版ではバックグラウンドでの自動スキャンは利用できません(Community版では、後述する右クリックからの明示的な実行のみが可能です)。
特定のリクエストについては、右クリックから「AI Passive Scan」を選択することで、明示的にスキャンを実行することもできます。自動実行と明示実行のいずれも、内部の解析処理は同じです。なお、AI Passive Scanの検出対象は、本拡張機能が対応している全62クラスの脆弱性分類XIIのうち、レスポンス解析のみで判定できる(ドキュメントで passive-only と記載された)脆弱性クラスですXIII。ペイロードを送信せずに判定できる、情報漏洩・セキュリティヘッダー欠如・エラーメッセージからの推測といったクラスが、これに該当します。
AI Active Scan
「AI Active Scan」という名前ですが、その検出ロジックの基本はルールベースです。この点を最初に押さえておくと、本機能の挙動が理解しやすくなります。公式ドキュメントの「How It Works」XIVを見ると、検出プロセスは次のように説明されています。リクエストからインジェクションポイント(URLパラメータ、bodyパラメータ、ヘッダー、Cookie、JSONフィールドなど)を自動的に抽出し、各ポイントに対して脆弱性クラス・リスクレベル・スキャンモードに応じたペイロードを送信します。そして、レスポンスを複数の検出手法で解析し、確定した結果をBurp Issueとして報告する、という流れです。そして、この「解析」に使われる検出手法は以下のとおりで、いずれも決められたルールに基づくものであり、ここにLLMの推論は入っていません。
表 1 AI Active Scan検出手法
それでは、AI(LLM)はどこで使われるのでしょうか。実際にLLMが活用される場合があるのは、AI Active Scanner設定内の「Adaptive Payloads」というチェックボックスを有効にした場合だけであり、このチェックボックスはデフォルトではOFFになっていますXV。デフォルト設定では、前述の静的なペイロードライブラリとコンテキストマッチングだけでスキャンが完結するため、LLMを呼び出しません。そのため、このチェックボックスの状態を確認するとよいでしょう。なお、紛らわしい点として、「Adaptive Payloads」チェックボックスがOFFの場合でも、AI Active Scanで作成された発見事項(Issue)には、BackendとModelが表示されるようです(前述の通りLLMは未使用にもかかわらず)。
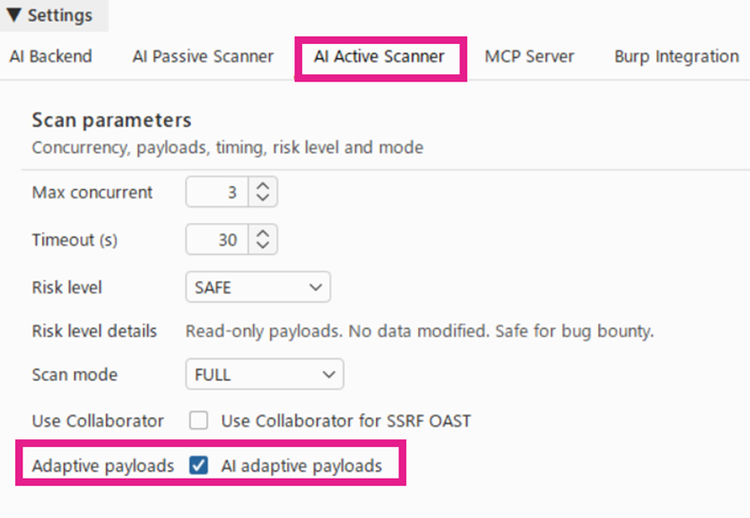
「Adaptive Payloads」を有効にすると、対象の技術スタック(例:MySQL、Django)や観測されたエラーパターン、パラメータ名・値をLLMに渡し、そのコンテキストに特化した追加のペイロードを生成させます。生成されたペイロードは、破壊的なコマンド(DROP、DELETE、TRUNCATE など)のブロックリストで検証されてから使用されます。
Targeted Testsサブメニュー
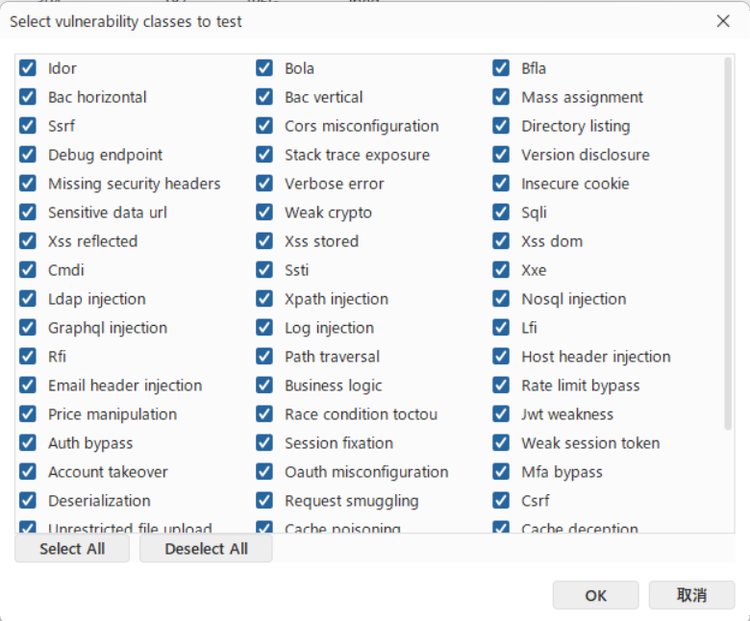
「AI Active Scan」が現在のScan Mode設定(BUG_BOUNTY / PENTEST / FULL)に従って自動的にテスト対象のクラスを決めるのに対し、「Targeted Tests」は、テストする脆弱性クラスを手動でピンポイントに絞り込むためのサブメニューです。裏側で使われるスキャンエンジンは、通常のAI Active Scanと同じものですXVI。
選択可能なサブメニューは以下のとおりです。
- SQLi
- XSS(Reflected)
- XSS(Stored)
- XSS(DOM)
- SSRF
- IDOR/BOLA
- Path Travrsal/LFI
- Command Injection
- SSTI
- XXE
- Open Redirect
- Custom
「Custom...」では全62クラスを個別に選択できます。
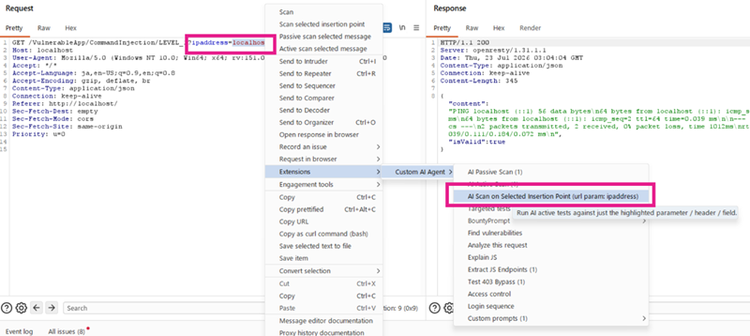
AI Scan on Selected Insertion Point
これは、リクエストの中から特定の1箇所(単一のパラメータ、ヘッダー、JSONフィールド、XML要素、パスセグメントのID)だけを狙い撃ちしてアクティブスキャンを行う機能ですXVII。前述のAI Active ScanやTargeted Testsがリクエスト全体からインジェクションポイントを自動的に抽出してスキャンするのに対し、こちらは「ここだけをテストしたい」という的を絞ったスキャンになります。使い方としては、Proxyタブなどのリクエスト上でスキャンしたい値(例えば user_id パラメータの値)をハイライトし、右クリックします。Custom AI Agentのメニューに、型と名前がラベルとして付いた形(例:AI Scan on Selected Insertion Point (json field: user_id))で、この項目が現れます。このスキャンは、通常のキューよりも高い優先度(priority 60)で処理されます。「この1つのパラメータだけを今すぐ確認したい」といった、ピンポイントな検証に向いた機能だと言えます。
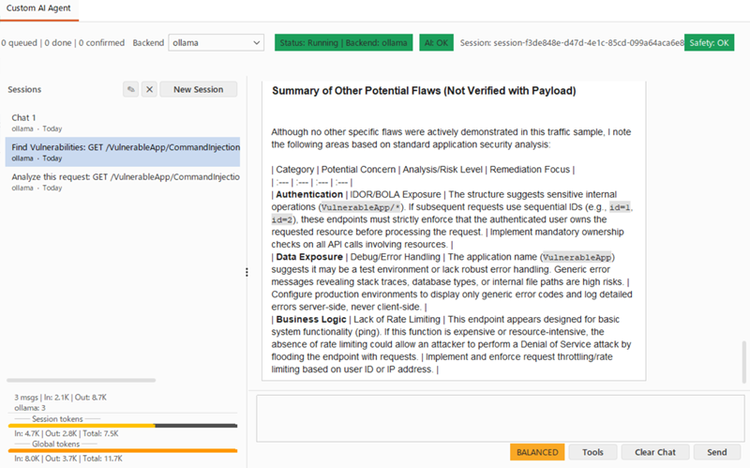
Find Vulnerabilities
「Find Vulnerabilities」は、選択したリクエスト/レスポンスからコンテキストを収集し、脆弱性を探すためのプロンプトテンプレートを添えたうえで、LLMとのチャットセッションを開く機能です。
実行すると、まずLLMに送信する前に内容を確認できる「Context Preview」ダイアログが表示されます。
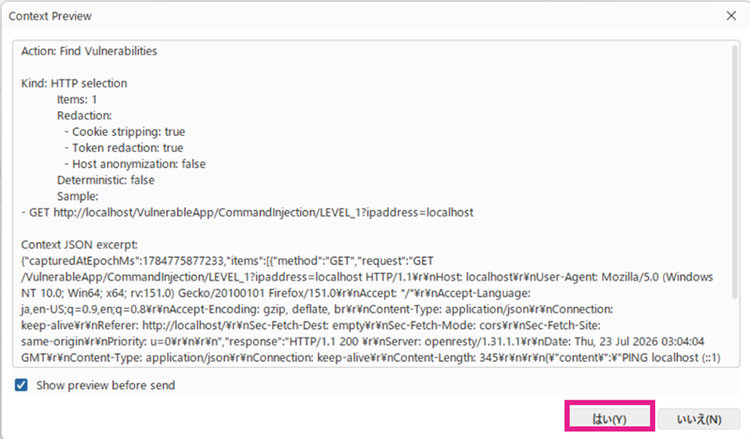
「はい」をクリックし次へ進みます。
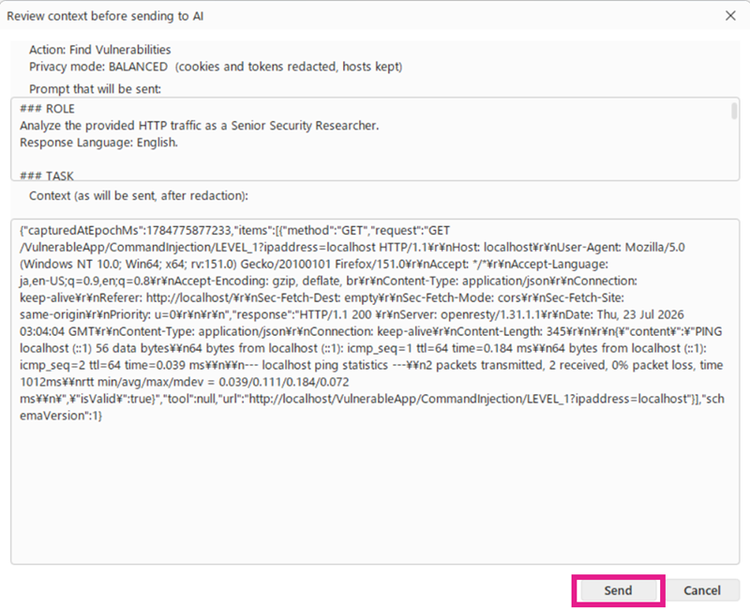
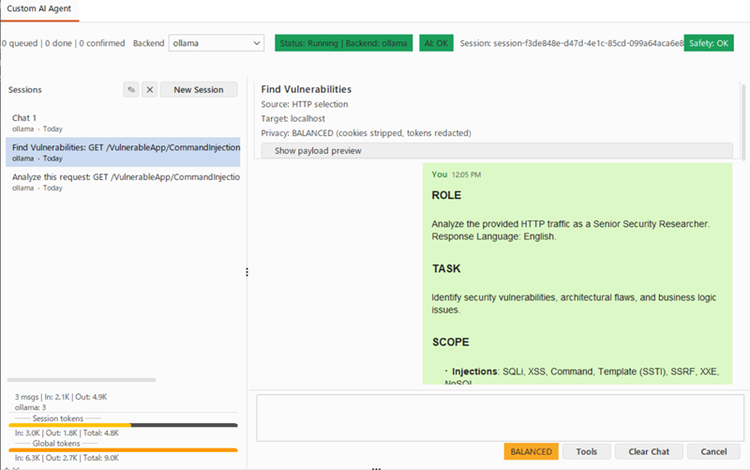
「Send」で次へ進みます。Custom AI Agentのタブに移行すると、チャットのセッションの形でLLMへの問い合わせが行われます。
Analyze this request
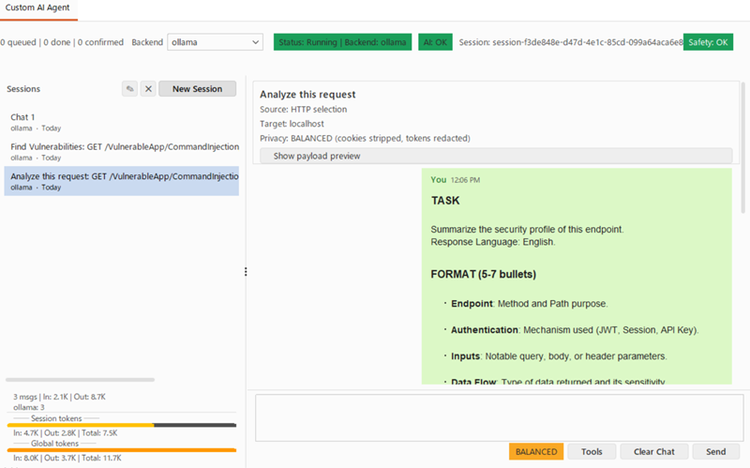
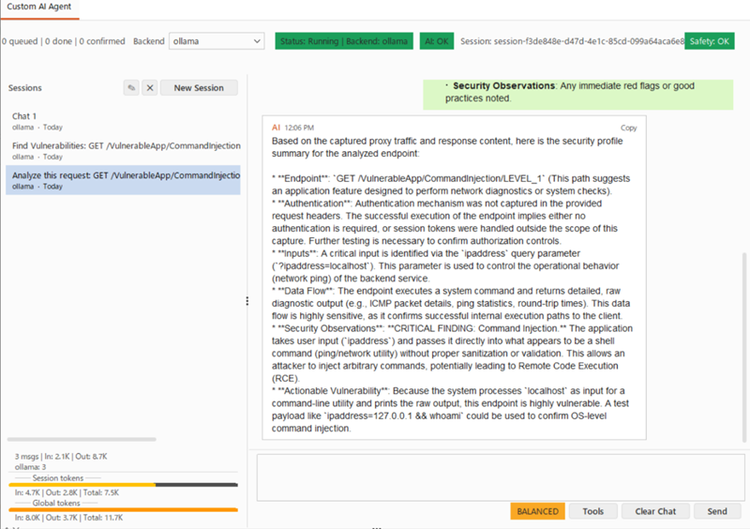
「Analyze this request」は、選択したリクエストの内容をLLMに解析・説明させる機能です。Find Vulnerabilitiesと同じく、コンテキストを収集し、プロンプトテンプレート(こちらは解析・要約向けのテンプレート)を添えて、チャットセッションを開きます。実行までの手順や様子はFind Vulnerabilitiesと同様です。Custom AI Agentのタブに移行すると、チャットのセッションの形でLLMへの問い合わせが行われます。
利用例②:発見事項(Issues)の確認
続いて、Targetタブや左下のAll issuesから表示した発見事項(Issues)を右クリックして使える機能をご紹介しますXVIII。なお、これらIssue上の右クリックメニュー(Issue Actions)は、Burp Suite Professionalで利用可能です。Issue上で右クリック → Extensions → Custom AI Agent から選択可能な機能は、以下のとおりです。
- Analyze this issue★後述
- Generate PoC & validate★後述
- Impact & severity★後述
- Full report★後述
- Custom prompts
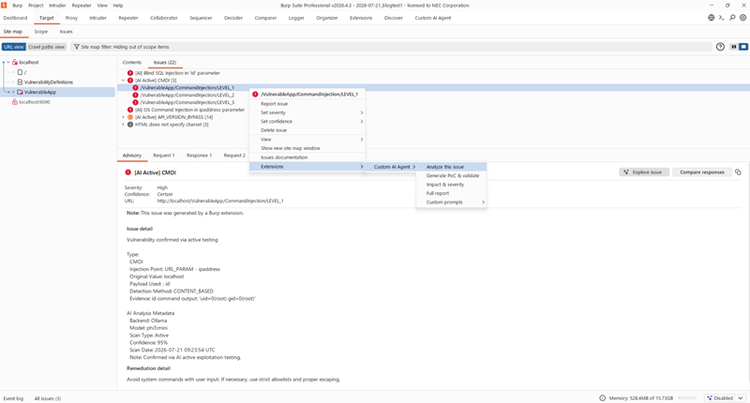
以下の各機能はいずれも、リクエストの解析機能と同じく、選択したIssueのコンテキストを収集し、送信前に「Context Preview」ダイアログで内容を確認したうえで、LLMとのチャットセッションを開く形で動作します。
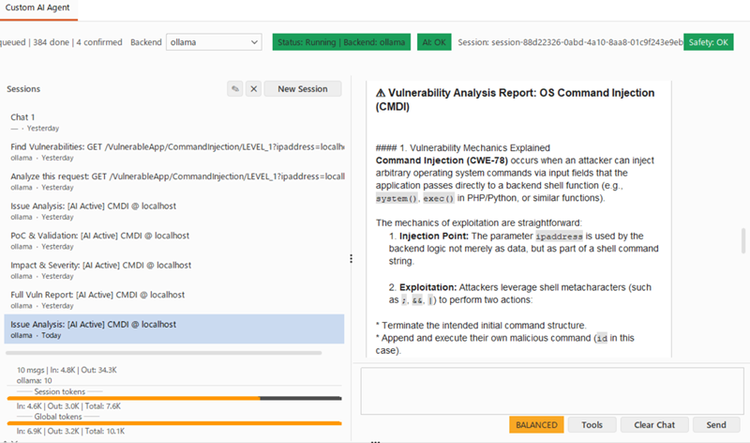
Analyze this issue
発見されたIssueについて、根本原因・証拠(evidence)・検証フローを含む詳細な解析をLLMに行わせる機能です。「なぜこの問題が起きているのか」「どのように確認すればよいのか」を掘り下げたいときに使用します。
利用方法は、Issue上で右クリック → Extensions → Custom AI Agent → Analyze this issue をクリックします。「Context Preview」が表示され、LLMへの送信前に内容を確認できます。「Send」を選択して次へ進みます。以降の機能も操作の流れは同様です。
Generate PoC & validate
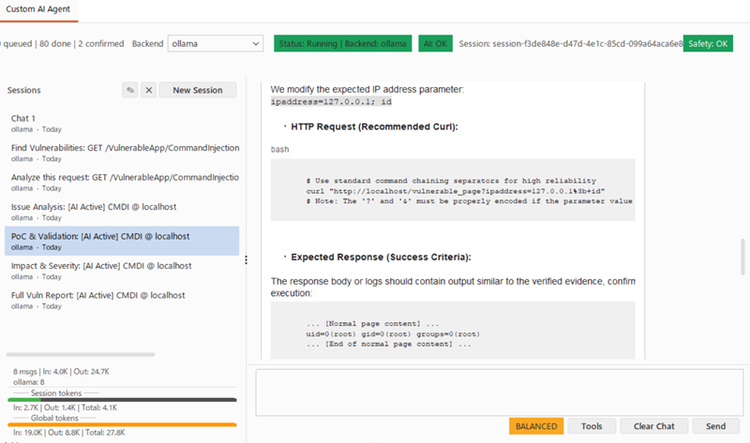
発見事項に対するPoC(概念実証)を、期待されるレスポンスと成功条件(success criteria)付きのステップバイステップ形式で生成する機能です。単にPoCを作成するだけでなく、「何をもって成功と判断するか」まで含めて提示してくれる点は、レポート作成や検証の手間を減らすことにつながると感じました。
Impact & severity
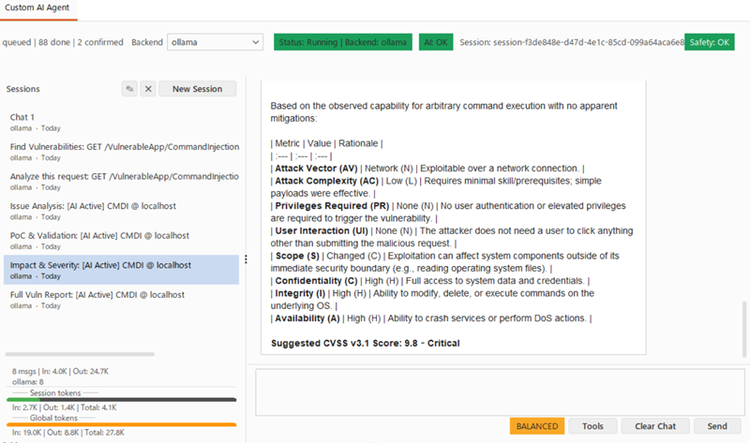
発見事項の影響度と深刻度をLLMに評価させる機能です。機密性・完全性・可用性(CIA)への影響、悪用可能性(exploitability)、ビジネスリスク、そしてCVSS的な観点での深刻度評価を出力してくれます。レポートの「深刻度」欄の草案作成に役立ちそうだと感じました。
Full report
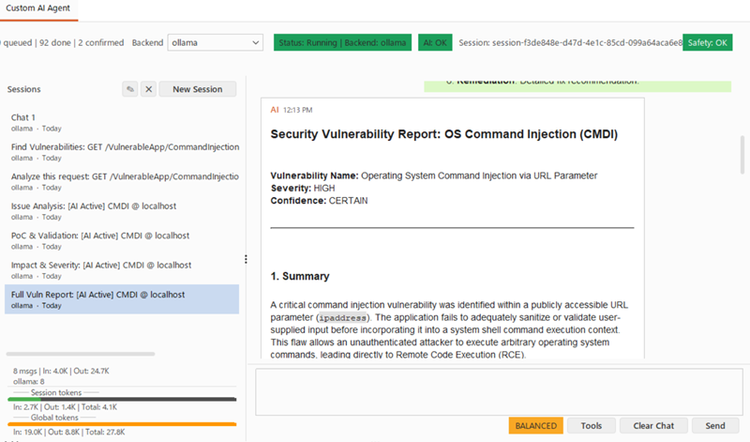
発見事項について、提出用に構造化された脆弱性レポートを生成する機能です。上記の各機能(原因分析・PoC・深刻度評価)の内容を、成果物として提出できる形にまとめる用途を想定した機能だと考えられます。
気になった点
実際に利用する中で、出力上限によるエラー、エラー発生時の調査、監査ログ、設定の反映について、いくつか注意が必要な点を確認しました。以下に、それぞれの状況と確認できた範囲を整理します。
Ollamaの空レスポンス
AI Loggerを確認していると次のようなエラーが多数発生していることを確認しました。
調査したところ、モデルがthinkingの出力中にnum_predictの上限(AI Active Scanでは1024)へ達し、回答本体を生成する前に処理が終了したことが原因とみられます。その結果、拡張機能が取得する回答本文が空になり、「Ollama response content was empty」というエラーが表示されていました。推論過程が長いモデルほど発生しやすい現象だと考えられます。対処候補としては、num_predictの上限を引き上げるソースコードの修正を実施する、thinking出力を抑えられるモデルや設定を利用する、入力コンテキストを減らす、といった方法が考えられます。なお、先述のSmall model modeは入力サイズを抑える機能であり、出力側の上限を直接変更するものではありません。
エラー発生時の調査
LLM呼び出しでエラーが発生した際、AI Logger上にレスポンス全体が表示されず、原因の特定に時間がかかりました。今回は、ソースコードを編集してリクエストとレスポンスをファイルに出力することで、空レスポンスの原因を確認できました。オープンソースソフトウェアであるため、必要に応じて内部処理まで調査できる点は利点だと感じました。
監査ログに記録される情報
監査ログ(audit.jsonl)に残る情報は、機能によって異なります。チャット系機能では、同じトレースIDのイベントをつなぎ合わせることで応答全文を復元できます。一方、スキャナー系では文字数やタイトル、深刻度などのメタデータが中心で、reasoningや詳細な応答は残りません。LLMへの入出力を完全な証跡として残したい場合は注意が必要です。
設定変更が反映されない場合
本拡張機能の設定変更が反映されないことがありました。その場合は、ExtensionsタブでLoadedのチェックを一度外して拡張機能を無効化し、再度チェックを入れて読み込み直すと反映されました。
考察:LLMの性能と拡張機能の工夫
今回いくつかの機能を触ってみて感じたのは、Find Vulnerabilities 、Analyze this requestやGenerate PoC & validateといった、チャットへのラッパーとして動作する機能の出力品質は、使用するLLMのモデル性能に強く依存するという点です。これらの機能は、Burpから収集したリクエスト/レスポンスのコンテキストと、あらかじめ用意されたプロンプトテンプレートをLLMに渡してチャットさせる、という構造になっています。したがって、最終的な出力の質、すなわち脆弱性の見立ての正確さ、PoCの妥当性、レポートの読みやすさなどは、そこで動作しているモデルの性能に大きく左右されます。今回のようにパラメータサイズの小さいローカルモデルを使う場合は、この影響がとりわけ出やすいと感じました。
一方、拡張機能側には、LLMを扱いやすくする工夫も見られました。小型モデル向けの機能と、モデルの規模を問わず出力の不確実性に備える仕組みに分けられます。
小型・低コンテキストのモデルを想定した機能
- Small model mode(前述):入力するコンテキストの文字数を制限し、小型モデルでのコンテキスト超過を防ぎます。設定画面にも「1278トークンクラスのローカルモデル向け」と明記されています。
回答の方向性を整え、出力の揺れに備えるための仕組み
- Agent Profiles:pentester / bughunter / auditorなどの役割別プロンプトを設定し、回答の方向性を整えます。
- Prompt Templates:各機能のプロンプトを、使用するモデルに合わせて調整できます。
- 構造化出力への耐性処理:余分な説明を含む出力から有効なJSONを抽出してパースします。また、バッチ処理に失敗した場合は、個別解析へ切り替えるフォールバックも備えています。
これらはモデル自体の推論能力を高めるものではありませんが、限られた性能のモデルを扱いやすくし、出力の揺れを吸収するための工夫です。特にローカルLLMや小型モデルでは、こうした機能を組み合わせることで実用性を高められそうです。
まとめ
本記事では、Burp Suiteの拡張機能「Custom AI Agent」を取り上げ、ローカルLLMのOllamaと組み合わせて、主な機能を検証しました。検証の結果、各機能は、手動診断を支援する補助ツールとして活用できる可能性があると感じました。特に、リクエストや発見事項の分析、PoCと成功条件の作成は診断作業の効率化が期待できます。一方で、出力品質は使用するLLMの性能に大きく左右されます。今回使用した小型のローカルモデルでも一通りの機能を試すことができましたが、出力上限によるエラーや回答精度は課題と考えます。実運用では、用途に適したLLMプロバイダーやモデルを選定するとともに、生成された内容を参考情報として扱い、最終的には利用者自身が事実関係や妥当性を確認することが重要です。今後は、ClaudeなどのAIエージェントからMCP経由で本拡張機能を操作する方法についても検証したいと考えています。
本記事が、AIを活用したセキュリティ診断を検討する際の参考になれば幸いです。
参考文献
I Custom AI Agent
https://github.com/six2dez/burp-ai-agent
MIT license
Ⅱ Ollama
https://ollama.com/
Ⅲ gemma4
https://ollama.com/library/gemma4
IV Overview
https://burp-ai-agent.six2dez.com/
V Key Features
https://burp-ai-agent.six2dez.com/#key-features
VI VulnerableApp
https://github.com/SasanLabs/VulnerableApp
Apache-2.0 license
VII トレーニングコンテンツ:脆弱なウェブアプリケーション「VulnerableAPP」のご紹介
https://group.nec/jp/ja/solutions/cybersecurity/blog/220520
VIII Backends Overview
https://burp-ai-agent.six2dez.com/backends/overview
IX Privacy Modes
https://burp-ai-agent.six2dez.com/privacy-and-logging/privacy-modes
X Audit Logging
https://burp-ai-agent.six2dez.com/privacy-and-logging/audit-logging
XI AI Logger Tab
https://burp-ai-agent.six2dez.com/privacy-and-logging/ai-request-logger#ai-logger-tab
XII Vulnerability Classes
https://burp-ai-agent.six2dez.com/scanners/active#vulnerability-classes
XIII Active AI Scanner
https://burp-ai-agent.six2dez.com/scanners/active
> "Note: Classes marked (passive-only) are detected through response analysis and cannot be actively tested with payloads."
XIV How It Works
https://burp-ai-agent.six2dez.com/scanners/active#how-it-works
XV Adaptive AI Payloads
https://burp-ai-agent.six2dez.com/scanners/active#adaptive-ai-payloads
XVI Targeted Tests (Context Menu)
https://burp-ai-agent.six2dez.com/scanners/active#targeted-tests-context-menu
XVII AI Scan on Selected Insertion Point
https://burp-ai-agent.six2dez.com/user-guide/context-menus#ai-scan-on-selected-insertion-point
XVIII Issue Actions (Burp Pro)
https://burp-ai-agent.six2dez.com/user-guide/context-menus#issue-actions-burp-pro
執筆者プロフィール
中島 健児(なかしま けんじ)
担当領域:リスクハンティング
専門分野:脆弱性診断、ペネトレーションテスト、インシデント対応
NECがお客様へ納品するシステム・製品へのリスクアセスメント/脆弱性検査/ペネトレーションテストを通じて、安全・安心なシステム構築を支援する業務に従事
CISSP、情報処理安全確保支援士(RISS)、GIAC(GCPN,GREM)保持